Wie wird man gut darin, ein T-Shirt zu falten? Jemand zeigt einem, wie es geht, und dann faltet man sehr viele T-Shirts. Das Zeigen verschafft einem den Einstieg, aber erst die Übung macht schnell und zuverlässig. Bei Sereact ist das eine zentrale Herausforderung, die wir angehen. Unsere Roboter arbeiten in der Logistik, wo ständig neue Artikel und neue Aufgaben hinzukommen. Für uns lautet die Frage, wie schnell ein Roboter bei etwas Neuem zuverlässig wird und ob das, was ein Roboter lernt, jedem Roboter in der Flotte zugutekommen kann.
Warum Imitation nicht ausreicht
Heutige Robotermodelle wie Vision-Language-Action-Modelle (VLAs) oder World-Action-Modelle (WAMs) lernen fast ausschließlich durch Imitation. Ein Mensch führt eine Aufgabe vor, und das Modell lernt, sie nachzuahmen. Das reicht aus, um beeindruckendes, menschenähnliches Verhalten zu zeigen, doch in der Praxis sind diese Modelle nicht zuverlässig. Macht der Roboter einen kleinen Fehler, gerät er in eine Situation, die keine Demonstration abgedeckt hat, und ein Fehler zieht den nächsten nach sich. Die übliche Abhilfe ist Handarbeit: weitere Demonstrationen aufzeichnen, die zeigen, wie man sich aus Fehlern wieder befreit, oder einen Menschen eingreifen lassen, der den Roboter während der Arbeit korrigiert.
Die Herausforderung von Reinforcement Learning in der realen Welt
Reinforcement Learning (RL) verspricht etwas Besseres: Der Roboter probiert etwas aus, beobachtet das Ergebnis und passt sich an. Das Hindernis ist die Zahl der nötigen Versuche. Eine Fähigkeit von Grund auf zu lernen kann Millionen von Versuchen erfordern, was nur in der Simulation bezahlbar ist. Deshalb war RL bisher vor allem bei Aufgaben erfolgreich, die sich leicht simulieren lassen. Weiche Gegenstände wie Kleidung gehören nicht dazu. Methoden, die tatsächlich auf echten Robotern lernen, waren bislang auf viele aufgabenspezifische Demonstrationen angewiesen, auf Hunderte bis tausend Übungsepisoden pro Aufgabe und oft auf einen Menschen, der den Roboter unterwegs korrigiert (Recap, RL tokens). Sie funktionieren, aber jede neue Aufgabe kostet weiterhin erhebliche Ressourcen, sowohl an Roboterzeit als auch an menschlicher Aufmerksamkeit. Das skaliert nicht auf Tausende von Aufgaben an vielen Standorten.
Wir stellen FLEX vor
Wir haben eine Methode namens FLEX (Flow Matching Learning from Experience) entwickelt, mit der sich ein Roboter aus wenigen Dutzend eigenen Versuchen verbessern kann, ohne dass jemand eingreift. Sie baut auf dem Wissen auf, das bereits in einem vortrainierten Modell steckt. Mit 50 Übungsversuchen pro Aufgabe steigerte sich das VLA-Backbone von Cortex 2.0 bei drei Aufgaben aus der Retourenbearbeitung von 60 bis 70% erfolgreich abgeschlossener Versuche auf 85 bis 100%, und es erledigte alle drei schneller. Dasselbe Üben verbesserte auch ein öffentlich verfügbares VLA, π0.5, doch Cortex 2.0 startete höher und endete höher: Je stärker das vortrainierte Modell, desto mehr holt es aus dem Üben heraus.
Warum ist Üben für einen Roboter schwierig?
Ein VLA hat bereits eine Policy: eine Art zu entscheiden, wie es sich als Nächstes bewegt, ausgehend von dem, was seine Kameras zeigen. Genau dafür wurde es trainiert, aber es macht Fehler. Beim Reinforcement Learning geht es darum, die Policy durch Versuch und Irrtum zu verändern.
Das ist nicht trivial, denn ob eine Aktion schlecht war, lässt sich nicht erkennen, indem man sie nur betrachtet. Derselbe Griff kann weit in der Zukunft zum Erfolg oder zum Misserfolg führen.
Um damit umzugehen, trainieren wir ein zweites Modell, den Critic. Er lernt, was man im RL eine Wertfunktion (Value Function) nennt: Von jedem Moment eines Versuchs aus schätzt er die Wahrscheinlichkeit, dass der Versuch erfolgreich endet. Mit dem Critic können wir den Vorteil (Advantage) jeder Aktion schätzen, die der Roboter ausgeführt hat: Ist es besser oder schlechter ausgegangen, als wir von der damaligen Ausgangslage aus erwartet hatten? Im besten Fall steht der Roboter am Ende weit besser da als erwartet. Er hat eine Abkürzung gefunden. Erst die Schätzung dieses Vorteils ermöglicht es einem Roboter überhaupt, aus Erfahrung zu lernen. Indem wir die Policy in Richtung vorteilhafteren Verhaltens verschieben, verbessern wir sowohl, wie oft der Roboter erfolgreich ist, als auch, wie schnell er ans Ziel kommt.
Zwei Wege, aus Erfahrung zu lernen
Eine Policy anhand solcher Vorteilsschätzungen zu verbessern, ist ein weit verbreiteter Ansatz. Was also ermöglicht es FLEX, bei realen Aufgaben so schnell zu lernen? Entscheidend ist, wie die Erfahrung genutzt wird. Im Reinforcement Learning unterscheidet man grundsätzlich zwei Arten, aus Erfahrung zu lernen:
- On-Policy-Lernen nutzt nur Erfahrung, die mit der aktuellen Policy gesammelt wurde. Sie bildet genau ab, was der Roboter gerade jetzt verbessern muss, gemessen an dem, womit er aktuell Schwierigkeiten hat. Der Nachteil: Sobald sich die Policy ändert, sind alle bisherigen Daten veraltet.
- Off-Policy-Lernen nutzt sämtliche Erfahrung, die jemals gesammelt wurde, auch mit anderen Policies. So lässt sich Erfahrung über die Zeit oder über eine ganze Flotte hinweg ansammeln. Der Nachteil: Alte Daten geben nicht mehr genau wieder, woran die Policy gerade jetzt arbeiten muss.
Bisherige Methoden setzen meist auf das eine oder das andere. On-Policy-Methoden brauchen so viele frische Daten, dass sie größtenteils in der Simulation geblieben sind. Off-Policy-Methoden für Robotermodelle verwerten Daten gut, benötigen aber nachweislich Hunderte bis Tausende von Versuchen, menschliche Eingriffe und aufgabenspezifische Demonstrationen.
Wie FLEX effizient lernt
Der entscheidende Unterschied bei FLEX ist, dass es die Datentypen adaptiv kombiniert. FLEX mischt Demonstrationen, Off-Policy-Daten und frische On-Policy-Erfahrung, um sich so effizient wie möglich zu verbessern. Das Verfahren läuft als Schleife aus vier Schritten ab, wie unten dargestellt:
- Üben. Der Roboter versucht sich mit seiner aktuellen Policy einige Male an der Aufgabe. Jeder Versuch endet als Erfolg oder als Fehlschlag.
- Merken. Die neuen Versuche werden einem Gedächtnis der letzten Runden hinzugefügt.
- Bewerten. Der Critic bewertet jede Aktion: Ist sie besser oder schlechter ausgegangen als erwartet?
- Verbessern. Die Policy wird adaptiv in Richtung vorteilhafter Aktionen verschoben. FLEX nutzt frische Erfahrung, um zu lernen, was die Policy gerade jetzt verbessern muss, Off-Policy-Daten, um auf frühere Erfahrung zurückzugreifen, und Demonstrationen, um die Policy daran zu erinnern, wie die Aufgabe ausgeführt wird.
Dann beginnt die Schleife mit der aktualisierten Policy von vorn.
Drei Prinzipien für effizientes Lernen aus Erfahrung
Wie schafft es FLEX, sich aus allen drei Datenquellen so effizient zu verbessern, während State-of-the-Art-Methoden damit kämpfen? FLEX lernt sowohl aus On-Policy- als auch aus Off-Policy-Daten und berücksichtigt dabei die Vor- und Nachteile beider.
On-Policy-Daten sind von hoher Qualität: Sie zeigen die Fehler und Erfolge, auf die die aktuelle Version der Policy tatsächlich stößt, und genau das sollte das Lernen verstärken. Aber sie sind knapp, und wenn dieselben wenigen Versuche für zu viele Updates wiederverwendet werden, führt das zu Overfitting und verschlechtert die Policy.
Off-Policy-Daten gibt es reichlich, aber sie bilden das aktuelle Verhalten der Policy nicht ab: woran sie gerade scheitert und wie sie sich verbessern kann.
Vor diesem Hintergrund folgt FLEX drei Prinzipien, um seine Daten so effizient wie möglich zu nutzen:
- Frischer Erfahrung mehr vertrauen als alter. FLEX nutzt Daten aus früheren Versionen seiner selbst, misst aber der gerade gesammelten Erfahrung mehr Bedeutung bei. Diese Erfahrung beschreibt am besten, worauf sich die Policy jetzt konzentrieren sollte: ihre jüngsten Versuche, Fehlschläge und Erfolge.
- Den Critic prüfen, bevor er die Policy lenkt. Bei so wenigen Daten kann neue Erfahrung außerhalb dessen liegen, was der Critic bisher gesehen hat. In solchen Situationen kann es die Policy in die Irre führen, dem Signal des Critic zu folgen. FLEX überprüft die Qualität des Critic und passt an, wie sehr es dessen Schätzungen bei der Verbesserung der Policy vertraut.
- Änderungen über die Zeit bestätigen. Eine Policy besteht aus Millionen einstellbarer Zahlen. Man kann sie sich als Drehregler vorstellen. Jedes Update schlägt eine Richtung vor, in die jeder einzelne Regler gedreht werden soll. Manche Vorschläge spiegeln eine echte Lektion wider, andere sind Zufall. Aufbauend auf Erkenntnissen zu Cautious Optimizers (Liang et al., 2026) dreht FLEX einen Regler nur dann, wenn der neue Vorschlag mit der Richtung übereinstimmt, in die dieser Regler zuletzt gedreht wurde. Eine Lektion, die immer wieder auftaucht, wird übernommen. Ein Einzelfall wird ignoriert.
Ergebnisse auf echten Robotern
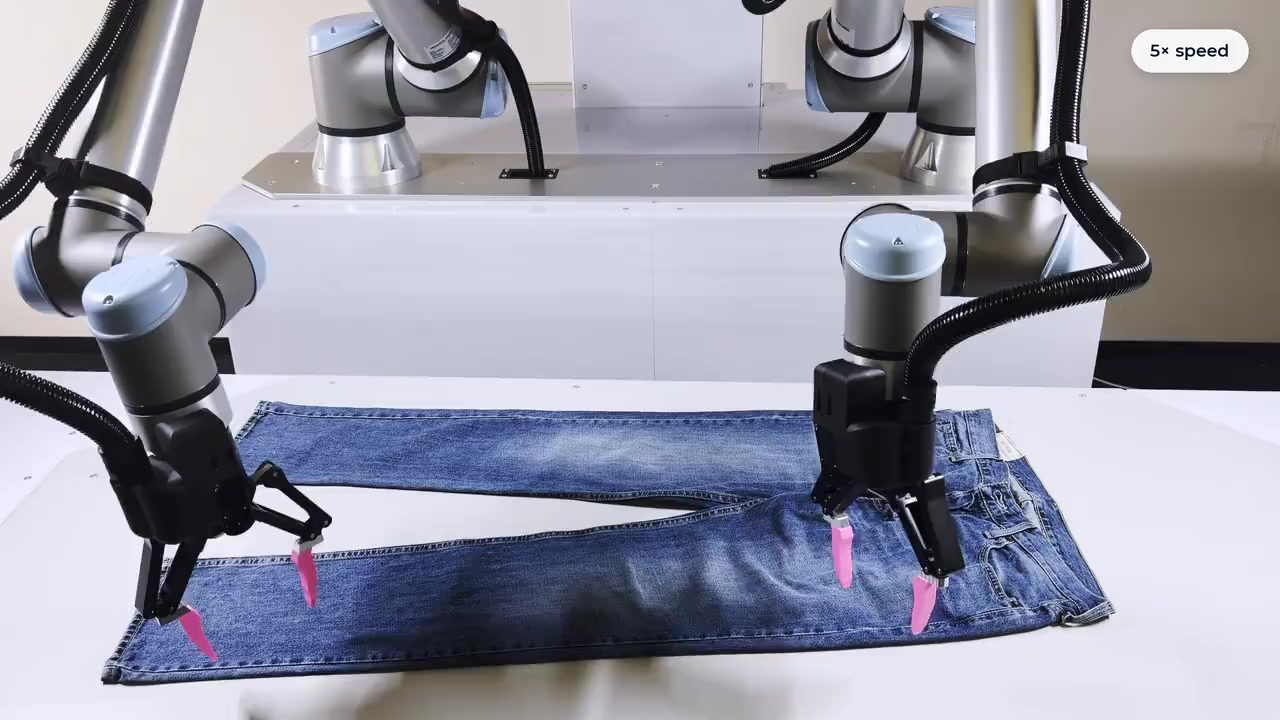
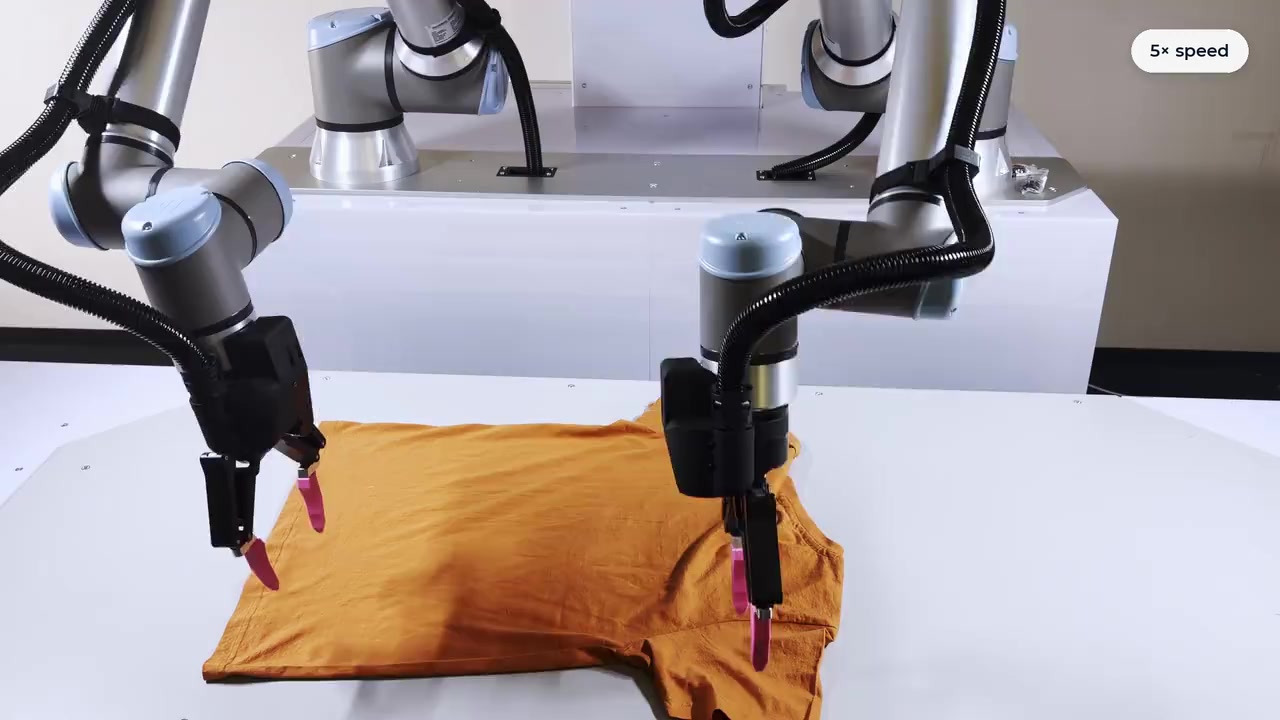
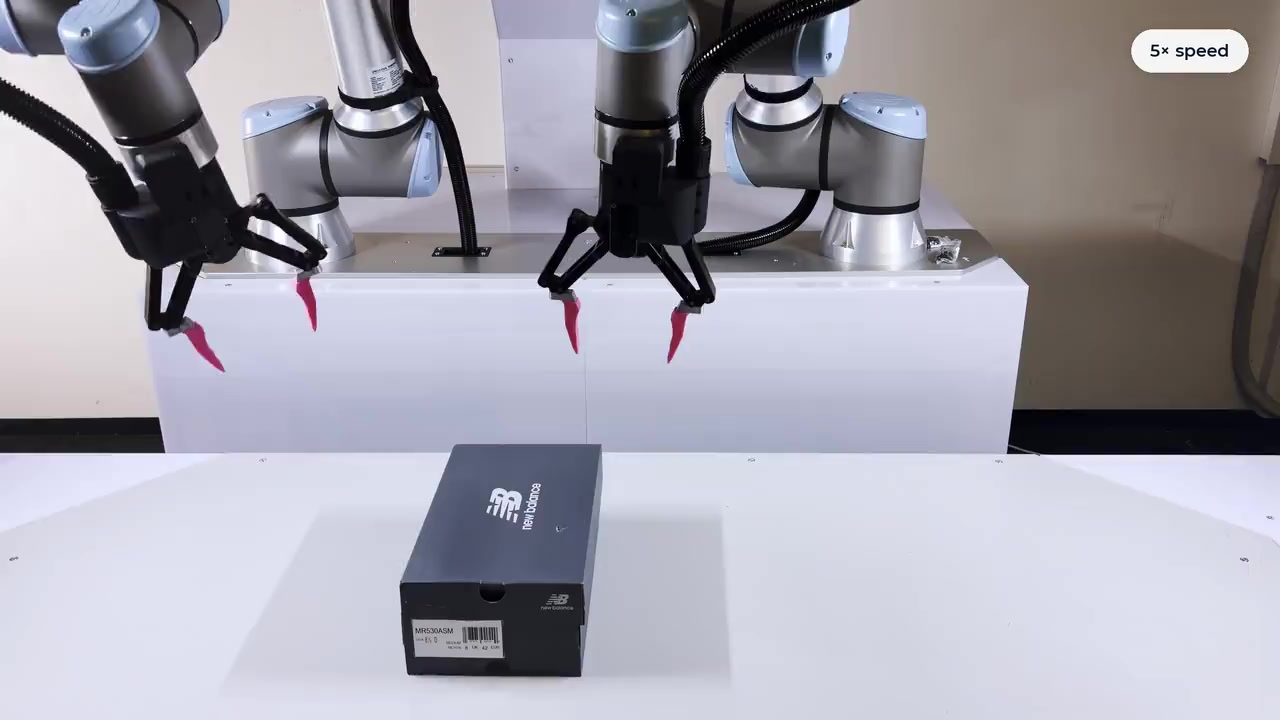
Jede Aufgabe begann mit 100 vorab gesammelten menschlichen Demonstrationen. Anschließend übte der Roboter 10 Runden mit je 5 Versuchen, ohne dass ihn jemand korrigierte. Wir haben zwei Modelle trainiert: das VLA-Backbone von Cortex 2.0, vortrainiert auf industriellen Roboterdaten, und π0.5, ein öffentlich verfügbares Modell.
- Besseres Pretraining hilft, aber nur bis zu einer Grenze. Solange es noch allein auf Imitation setzt, liegt Cortex 2.0 bei jeder Aufgabe von Beginn an vor π0.5. Das zeigt, dass stärker vortrainierte VLAs besser abschneiden, bei realen Aufgaben aber bei 60-70% an ihre Grenze stoßen.
- Ein stärkeres Backbone holt mehr aus dem Üben heraus. Beide VLAs verbessern sich, doch FLEX angewendet auf Cortex 2.0 ergibt die stärkste Kombination. Durch das Üben lernte es außerdem, eigene Fehler zu korrigieren, etwa indem es nach einem fehlgeschlagenen Griff erneut zugriff. π0.5 verbesserte sich vor allem dadurch, dass es weniger Fehler machte, und nicht durch neu entdecktes Korrekturverhalten.
- Beide wurden schneller. π0.5 war nach dem Üben 5 bis 20% früher fertig. Cortex 2.0 war bereits 17 bis 48% schneller als π0.5, und durch das Üben wurde es bei allen drei Aufgaben noch einmal schneller.
Gebaut für die Flotte
Ein einzelner Roboter, der übt, ist nützlich. Viele Roboter, die gemeinsam für eine geteilte Policy üben, sind ein skalierbarer Weg, aus einer rasch wachsenden Menge flottenweiter Erfahrung zu lernen. FLEX läuft auf einem Lernsystem, das für den Flotteneinsatz gebaut ist:
- Vor Ort läuft eine lokale Kopie der Policy direkt neben den Robotern, sodass die Steuerung nie auf einen entfernten Server warten muss.
- Erfahrung fließt nach oben. Jeder Versuch geht an einen Online-Puffer im Trainingscluster: Kamerabilder, Roboterzustand und ob er erfolgreich war. Die vorab gesammelten menschlichen Demonstrationen liegen in einem separaten Offline-Puffer.
- Policies fließen nach unten. Ein großer GPU-Cluster trainiert eine gemeinsame Policy auf der Erfahrung aller Roboter und sendet jede neue Version an jeden Standort.
Das ermöglicht flottenweites Lernen, das die Erfahrung der gesamten Flotte nutzt, um die Verbesserung zu beschleunigen. Entdeckt ein Roboter eine neue Technik, wird sie mit der neuen Version an alle Roboter verteilt, sodass auch diese die Technik nutzen können, um ihre Fähigkeiten weiter zu verbessern.
Ausblick
FLEX zeigt, dass sich hohe Erfolgsquoten bei realen Aufgaben aus wenigen Dutzend Versuchen erreichen lassen, ganz ohne Simulation oder manuelle menschliche Korrekturen. Damit ist der Kurs klar gesetzt: hin zu Robotern, die effizient lernen und dabei gleichzeitig Wert schaffen. Zwei Trends zeigen, in welche Richtungen sich das skalieren lässt. Erstens profitiert FLEX von starkem Pretraining und wird daher von den Bemühungen profitieren, auf immer größeren Mengen an Demonstrationsdaten zu trainieren. Zweitens ist FLEX bereit für den flottenweiten Einsatz und kann so die Erfahrung nutzen, die sich über eine wachsende Flotte hinweg ansammelt. Zusammen führt das zu Robotern, die ihre Effizienz rasch steigern, zuverlässig arbeiten und Umsatz generieren.