¿Cómo se aprende a doblar bien una camiseta? Alguien te enseña cómo hacerlo y luego doblas muchas camisetas. Que te lo enseñen te sirve para empezar, pero es la práctica lo que te hace rápido y fiable. En Sereact, este es uno de los retos centrales que estamos abordando. Nuestros robots trabajan en logística, donde llegan artículos y tareas nuevos constantemente. Para nosotros, la pregunta es con qué rapidez un robot se vuelve fiable en algo nuevo y si lo que aprende un robot puede beneficiar a todos los robots de la flota.
Por qué la imitación no basta
Los modelos robóticos actuales, como los modelos visión-lenguaje-acción (VLAs) o los modelos world-action (WAMs), aprenden casi exclusivamente por imitación. Una persona demuestra una tarea y el modelo aprende a imitarla. Eso basta para mostrar un comportamiento impresionante y parecido al humano, pero estos modelos no son fiables en la práctica. Cuando el robot comete un pequeño error, acaba en una situación que ninguna demostración cubría, y un error lleva al siguiente. El remedio habitual es manual: grabar más demostraciones de cómo recuperarse, o que una persona intervenga y corrija al robot mientras trabaja.
El reto del aprendizaje por refuerzo en el mundo real
El aprendizaje por refuerzo (RL) promete algo mejor: el robot lo intenta, observa el resultado y se ajusta. El obstáculo es cuántos intentos hacen falta. Aprender una habilidad desde cero puede requerir millones de intentos, algo que solo es asumible en simulación, y por eso el RL ha tenido éxito sobre todo en tareas fáciles de simular. Los artículos blandos, como la ropa, no lo son. Los métodos que sí aprenden en robots reales han dependido hasta ahora de muchas demostraciones específicas de cada tarea, de entre cientos y mil episodios de práctica por tarea y, a menudo, de una persona que corrige al robot sobre la marcha (Recap, RL tokens). Funcionan, pero cada tarea nueva sigue costando recursos considerables en tiempo de robot y atención humana. Eso no escala a miles de tareas en muchas instalaciones.
Presentamos FLEX
Hemos desarrollado un método llamado FLEX (Flow Matching Learning from Experience) que permite a un robot mejorar a partir de unas pocas decenas de intentos propios, sin que nadie intervenga. Se apoya en el conocimiento que ya contiene un modelo preentrenado. Con 50 intentos de práctica por tarea, el backbone VLA de Cortex 2.0 pasó de completar entre el 60 y el 70% de sus intentos a completar entre el 85 y el 100% en tres tareas de gestión de devoluciones, y terminó las tres más rápido. La misma práctica también mejoró un VLA público, π0.5, pero Cortex 2.0 partió más alto y terminó más alto: cuanto más sólido es el modelo preentrenado, más provecho saca de la práctica.
¿Por qué es difícil practicar para un robot?
Un VLA ya tiene una política: una forma de decidir, a partir de lo que muestran sus cámaras, cómo moverse a continuación. Para eso fue entrenado, pero comete errores. El aprendizaje por refuerzo consiste en cambiar la política mediante ensayo y error.
Esto no es sencillo, porque no se puede saber si una acción fue mala solo con mirarla. El mismo agarre puede llevar al éxito o al fracaso mucho más adelante.
Para resolverlo, entrenamos un segundo modelo, el crítico. Aprende lo que en RL se denomina función de valor: desde cualquier momento de un intento, estima la probabilidad de que ese intento termine con éxito. Con el crítico podemos estimar la ventaja de cada acción que realizó el robot: ¿salieron las cosas mejor o peor de lo que anticipábamos desde donde estábamos? En el mejor de los casos, el robot acaba mucho mejor de lo esperado. Ha encontrado un atajo. Estimar la ventaja es, en primer lugar, lo que hace posible que un robot aprenda de la experiencia. Al desplazar la política hacia comportamientos más ventajosos, mejoramos tanto la frecuencia con la que el robot tiene éxito como la rapidez con la que lo consigue.
Dos formas de aprender de la experiencia
Usar ventajas para mejorar una política es un enfoque muy extendido. Entonces, ¿qué permite a FLEX aprender tan rápido en tareas del mundo real? Todo se reduce a cómo se usa la experiencia. En el aprendizaje por refuerzo existe una dicotomía entre dos formas de aprender de la experiencia:
- El aprendizaje on-policy usa solo la experiencia recogida con la política actual. Esto representa con precisión lo que el robot necesita mejorar ahora mismo, dado aquello con lo que tiene dificultades actualmente. El inconveniente es que, en cuanto la política cambia, todos los datos anteriores quedan desfasados.
- El aprendizaje off-policy usa toda la experiencia recogida hasta el momento, incluso con otras políticas. Esto permite acumular experiencia a lo largo del tiempo o en toda una flota. El inconveniente es que los datos antiguos ya no reflejan con precisión lo que la política necesita mejorar ahora mismo.
Los métodos anteriores suelen apoyarse en uno u otro. Los métodos on-policy necesitan tantos datos nuevos que se han quedado mayoritariamente en simulación. Los métodos off-policy para modelos robóticos reutilizan bien los datos, pero han demostrado necesitar del orden de cientos a miles de intentos, intervenciones humanas y demostraciones específicas de cada tarea.
Cómo aprende FLEX de forma eficiente
La diferencia clave de FLEX es que combina de forma adaptativa los distintos tipos de datos. Mezcla las demostraciones, los datos off-policy y la experiencia on-policy reciente para mejorar de la forma más eficiente posible. Funciona como un bucle de cuatro pasos, como se ilustra a continuación:
- Practicar. El robot intenta la tarea unas cuantas veces con su política actual. Cada intento termina en éxito o en fracaso.
- Recordar. Los nuevos intentos se añaden a una memoria de las últimas rondas.
- Evaluar. El crítico puntúa cada acción: ¿salió mejor o peor de lo esperado?
- Mejorar. La política se desplaza de forma adaptativa hacia las acciones ventajosas. FLEX usa la experiencia reciente para aprender en qué necesita mejorar la política ahora mismo, los datos off-policy para aprovechar la experiencia previa y las demostraciones para recordarle a la política cómo se hace la tarea.
Después, el bucle vuelve a empezar con la política actualizada.
Tres principios para aprender de la experiencia de forma eficiente
¿Cómo consigue FLEX mejorar con tanta eficiencia a partir de las tres fuentes de datos, mientras que los métodos más avanzados tienen dificultades? FLEX aprende tanto de datos on-policy como off-policy, y tiene en cuenta los pros y los contras de cada uno.
Los datos on-policy son de alta calidad: muestran los errores y los aciertos que la versión actual de la política encuentra realmente, que es exactamente lo que el aprendizaje debe reforzar. Pero son escasos, y reutilizar los mismos pocos intentos en demasiadas actualizaciones provoca sobreajuste y degrada la política.
Los datos off-policy son abundantes, pero no representan el comportamiento actual de la política: en qué está fallando ahora y cómo puede mejorar.
Teniendo esto en cuenta, FLEX sigue tres principios para aprovechar sus datos de la forma más eficiente posible:
- Confiar más en la experiencia reciente que en la antigua. FLEX usa datos de versiones anteriores de sí mismo, pero da más importancia a la experiencia que acaba de recoger. Esa experiencia describe mejor en qué debe centrarse ahora la política: sus intentos, fallos y aciertos recientes.
- Validar al crítico antes de que guíe a la política. Con tan pocos datos, la nueva experiencia puede quedar fuera de lo que el crítico ha visto antes. En esas situaciones, seguir la señal del crítico puede desviar a la política. FLEX comprueba la calidad del crítico y ajusta cuánto confía en sus estimaciones al mejorar la política.
- Confirmar los cambios a lo largo del tiempo. Una política está formada por millones de números ajustables. Piensa en ellos como si fueran mandos giratorios. Cada actualización sugiere una dirección en la que girar cada uno. Algunas sugerencias reflejan una lección real y otras son pura casualidad. Basándose en los hallazgos sobre los cautious optimizers (Liang et al., 2026), FLEX solo gira un mando cuando la nueva sugerencia coincide con la dirección en la que ese mando ha estado girando recientemente. Una lección que se repite se aplica. Una sugerencia aislada se ignora.
Resultados en robots reales
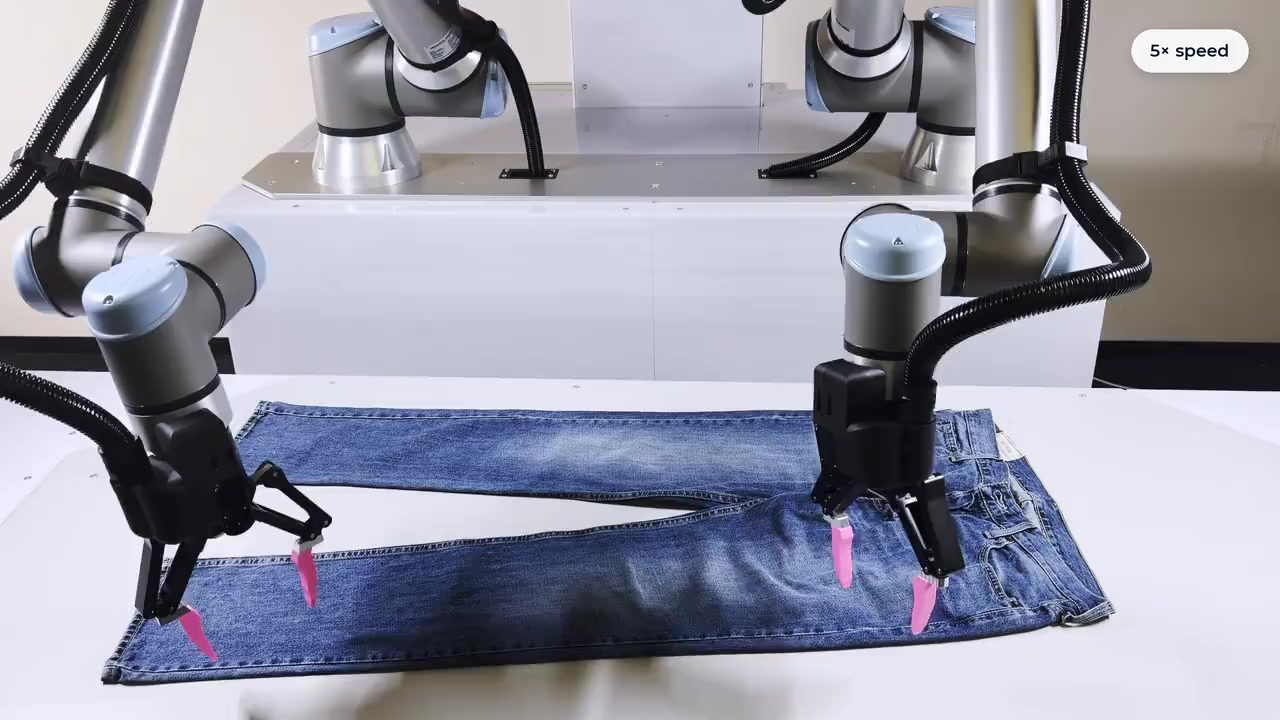
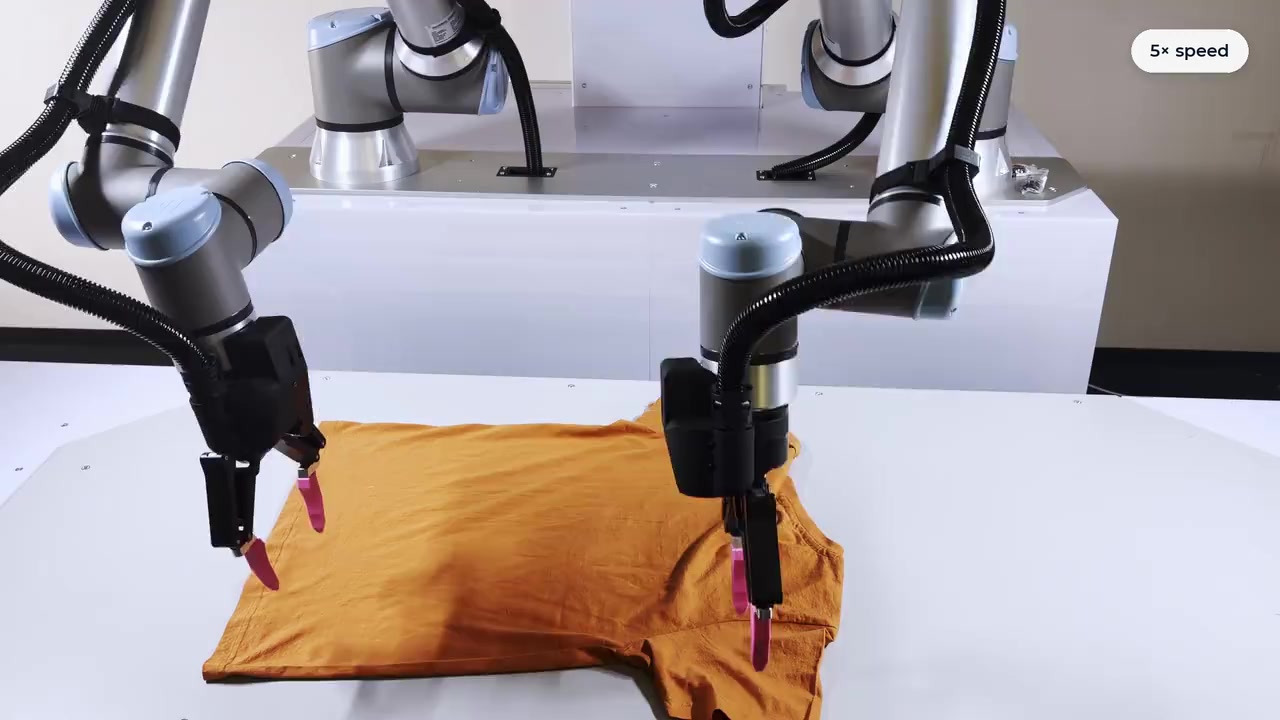
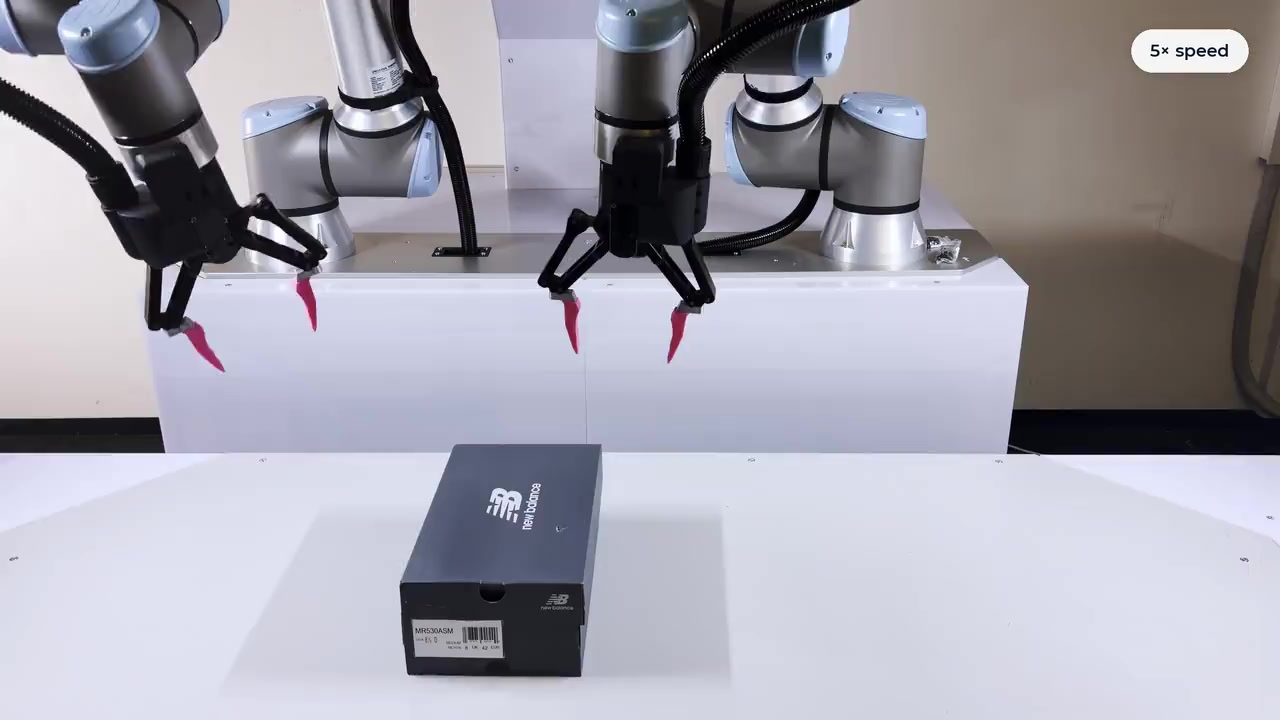
Cada tarea partió de 100 demostraciones humanas recogidas previamente. Después, el robot practicó durante 10 rondas de 5 intentos, sin que nadie lo corrigiera. Entrenamos dos modelos: el backbone VLA de Cortex 2.0, preentrenado con datos de robots industriales, y π0.5, un modelo disponible públicamente.
- Un mejor preentrenamiento ayuda, pero hasta cierto punto. Basándose todavía en la imitación, Cortex 2.0 parte con ventaja en todas las tareas frente a π0.5, lo que demuestra que los VLAs preentrenados más sólidos rinden mejor, pero se estancan en el 60-70% en tareas del mundo real.
- Un backbone más sólido saca más provecho de la práctica. Ambos VLAs mejoran, pero aplicar FLEX a Cortex 2.0 da como resultado la combinación más potente. Con la práctica, también aprendió a recuperarse de sus propios errores, por ejemplo volviendo a agarrar tras un agarre fallido. π0.5 mejoró sobre todo cometiendo menos errores, no descubriendo nuevos comportamientos correctivos.
- Ambos se volvieron más rápidos. π0.5 terminó entre un 5 y un 20% antes tras la práctica. Cortex 2.0 ya era entre un 17 y un 48% más rápido que π0.5, y la práctica lo hizo aún más rápido en las tres tareas.
Diseñado para una flota
Que un robot practique es útil. Que muchos robots practiquen para una única política compartida es una forma escalable de aprender de la experiencia de toda la flota, cuyo volumen crece rápidamente. FLEX se ejecuta sobre un sistema de aprendizaje diseñado para el despliegue en flota:
- En las instalaciones, una copia local de la política se ejecuta junto a los robots, de modo que el control nunca tiene que esperar a un servidor lejano.
- La experiencia sube. Cada intento va a un búfer online en el clúster de entrenamiento: imágenes de cámara, estado del robot y si tuvo éxito o no. Las demostraciones humanas recogidas previamente se guardan en un búfer offline separado.
- Las políticas bajan. Un clúster de GPU a gran escala entrena una única política compartida con la experiencia de todos los robots y envía cada nueva versión a todas las instalaciones.
Esto hace posible el aprendizaje a escala de flota, que puede aprovechar la experiencia de toda la flota para acelerar la mejora. Si un robot descubre una nueva técnica, esta se distribuye a todos los robots con la nueva versión, lo que les permite usarla para seguir mejorando sus habilidades.
El camino por delante
FLEX demuestra que es posible alcanzar altas tasas de éxito en tareas del mundo real a partir de unas pocas decenas de intentos, sin simulación ni correcciones humanas manuales. Esto marca un rumbo claro hacia robots capaces de aprender de forma eficiente mientras generan valor. Dos tendencias señalan las direcciones de escalado. En primer lugar, FLEX se beneficia de un preentrenamiento sólido, por lo que sacará partido de los esfuerzos por entrenar con cantidades cada vez mayores de datos de demostración. En segundo lugar, como FLEX está preparado para el despliegue a escala de flota, puede aprovechar la experiencia acumulada en una flota cada vez mayor. Juntas, estas tendencias conducen a robots que mejoran rápidamente su eficiencia y que son fiables y generan ingresos.