Comment devient-on doué pour plier un T-shirt ? Quelqu'un vous montre comment faire, puis vous pliez beaucoup de T-shirts. La démonstration vous met sur la voie, mais c'est la pratique qui vous rend rapide et fiable. Chez Sereact, c'est l'un des défis centraux auxquels nous nous attaquons. Nos robots travaillent dans la logistique, où de nouveaux articles et de nouvelles tâches arrivent en permanence. Pour nous, la question est de savoir à quelle vitesse un robot devient fiable sur quelque chose de nouveau, et si ce qu'apprend un robot peut profiter à tous les robots de la flotte.
Pourquoi l'imitation ne suffit pas
Les modèles robotiques actuels, comme les modèles vision-langage-action (VLAs) ou les world-action models (WAMs), apprennent presque entièrement par imitation. Une personne démontre une tâche et le modèle apprend à l'imiter. Cela suffit pour présenter des comportements impressionnants, proches de ceux d'un humain, mais ces modèles ne sont pas fiables en pratique. Lorsque le robot commet une petite erreur, il se retrouve dans une situation qu'aucune démonstration ne couvrait, et une erreur en entraîne une autre. Le remède habituel est manuel : enregistrer davantage de démonstrations montrant comment se rattraper, ou faire intervenir une personne pour corriger le robot pendant qu'il travaille.
Le défi de l'apprentissage par renforcement dans le monde réel
L'apprentissage par renforcement (RL) promet mieux : le robot essaie, observe le résultat et s'ajuste. L'obstacle, c'est le nombre d'essais nécessaires. Apprendre une compétence à partir de zéro peut demander des millions de tentatives, ce qui n'est abordable qu'en simulation, et c'est pourquoi le RL a surtout réussi sur des tâches faciles à simuler. Ce n'est pas le cas des objets souples comme les vêtements. Les méthodes qui apprennent bel et bien sur de vrais robots se sont jusqu'ici appuyées sur de nombreuses démonstrations propres à chaque tâche, sur des centaines voire un millier d'épisodes de pratique par tâche, et souvent sur une personne qui corrige le robot en cours de route (Recap, RL tokens). Elles fonctionnent, mais chaque nouvelle tâche coûte encore des ressources considérables, en temps robot comme en attention humaine. Cela ne passe pas à l'échelle de milliers de tâches réparties sur de nombreux sites.
Présentation de FLEX
Nous avons développé une méthode appelée FLEX (Flow Matching Learning from Experience) qui permet à un robot de s'améliorer à partir de quelques dizaines de ses propres tentatives, sans aucune intervention humaine. FLEX s'appuie sur les connaissances déjà présentes dans un modèle pré-entraîné. Avec 50 tentatives de pratique par tâche, le backbone VLA de Cortex 2.0 est passé de 60 à 70% de tentatives réussies à 85 à 100% sur trois tâches de traitement des retours, et il les a toutes les trois accomplies plus rapidement. La même pratique a également amélioré un VLA public, π0.5, mais Cortex 2.0 est parti plus haut et a terminé plus haut : plus le modèle pré-entraîné est solide, plus il tire profit de la pratique.
Pourquoi la pratique est-elle difficile pour un robot ?
Un VLA dispose déjà d'une politique : une façon de décider, à partir de ce que montrent ses caméras, du prochain mouvement à effectuer. C'est ce pour quoi il a été entraîné, mais il commet des erreurs. L'apprentissage par renforcement consiste à modifier la politique par essais et erreurs.
Ce n'est pas simple, car on ne peut pas savoir si une action était mauvaise simplement en l'observant. Une même saisie peut mener à un succès ou à un échec bien plus tard.
Pour y remédier, nous entraînons un second modèle, le critique. Il apprend ce que le RL appelle une fonction de valeur : à n'importe quel moment d'une tentative, il estime la probabilité que celle-ci se termine par un succès. Grâce au critique, nous pouvons estimer l'avantage de chaque action effectuée par le robot : les choses ont-elles tourné mieux ou moins bien que ce que nous anticipions compte tenu de la situation ? Dans le meilleur des cas, le robot se retrouve dans une position bien plus favorable que prévu. Il a trouvé un raccourci. C'est l'estimation de l'avantage qui permet, tout simplement, à un robot d'apprendre de son expérience. En orientant la politique vers des comportements plus avantageux, nous améliorons à la fois la fréquence à laquelle le robot réussit et la rapidité avec laquelle il y parvient.
Deux façons d'apprendre de l'expérience
Utiliser les avantages pour améliorer une politique est une approche largement répandue. Alors, qu'est-ce qui permet à FLEX d'apprendre aussi rapidement sur des tâches réelles ? Tout dépend de la manière dont l'expérience est utilisée. En apprentissage par renforcement, il existe une dichotomie entre deux façons d'apprendre de l'expérience :
- L'apprentissage on-policy n'utilise que l'expérience collectée avec la politique actuelle. Celle-ci représente fidèlement ce que le robot doit améliorer en ce moment, compte tenu de ses difficultés actuelles. L'inconvénient est que dès que la politique change, toutes les données précédentes deviennent obsolètes.
- L'apprentissage off-policy utilise toute l'expérience jamais collectée, y compris avec d'autres politiques. Cela permet d'accumuler de l'expérience au fil du temps, ou à l'échelle d'une flotte. L'inconvénient est que les anciennes données ne reflètent plus fidèlement ce que la politique doit améliorer en ce moment.
Les méthodes précédentes s'appuient généralement sur l'une ou l'autre. Les méthodes on-policy ont besoin de tant de données fraîches qu'elles sont pour la plupart restées cantonnées à la simulation. Les méthodes off-policy pour les modèles robotiques réutilisent bien les données, mais se sont avérées nécessiter de l'ordre de centaines à milliers d'essais, des interventions humaines et des démonstrations propres à chaque tâche.
Comment FLEX apprend efficacement
Ce qui distingue FLEX, c'est qu'il combine les différents types de données de manière adaptative. Il mélange les démonstrations, les données off-policy et l'expérience on-policy fraîche afin de s'améliorer le plus efficacement possible. Il fonctionne comme une boucle en quatre étapes, illustrée ci-dessous :
- Pratiquer. Le robot tente la tâche quelques fois avec sa politique actuelle. Chaque tentative se solde par un succès ou un échec.
- Mémoriser. Les nouvelles tentatives sont ajoutées à une mémoire des derniers cycles.
- Évaluer. Le critique note chaque action : a-t-elle tourné mieux ou moins bien que prévu ?
- Améliorer. La politique est orientée de manière adaptative vers les actions avantageuses. FLEX utilise l'expérience fraîche pour apprendre ce que la politique doit améliorer en ce moment, les données off-policy pour tirer parti de l'expérience passée, et les démonstrations pour rappeler à la politique comment la tâche s'effectue.
Puis la boucle recommence avec la politique mise à jour.
Trois principes pour apprendre efficacement de l'expérience
Comment FLEX parvient-il à s'améliorer aussi efficacement grâce à ces trois sources de données, là où les méthodes de pointe peinent ? FLEX apprend à la fois des données on-policy et off-policy, en tenant compte des atouts et des inconvénients de chacune.
Les données on-policy sont de grande qualité : elles montrent les erreurs et les réussites que la version actuelle de la politique rencontre réellement, soit exactement ce que l'apprentissage doit renforcer. Mais elles sont rares, et réutiliser les mêmes quelques tentatives pour un trop grand nombre de mises à jour entraîne un surapprentissage et dégrade la politique.
Les données off-policy sont abondantes, mais elles ne représentent pas le comportement actuel de la politique : ce sur quoi elle échoue maintenant, et comment elle peut s'améliorer.
Dans cette optique, FLEX suit trois principes pour exploiter ses données le plus efficacement possible :
- Faire davantage confiance à l'expérience fraîche qu'à l'ancienne. FLEX utilise des données issues de ses versions précédentes, mais accorde plus d'importance à l'expérience qu'il vient de collecter. C'est elle qui décrit le mieux ce sur quoi la politique doit se concentrer maintenant : ses tentatives, ses échecs et ses réussites les plus récents.
- Vérifier le critique avant qu'il ne guide la politique. Avec si peu de données, une nouvelle expérience peut sortir de ce que le critique a déjà vu. Dans ces situations, suivre le signal du critique peut égarer la politique. FLEX vérifie la qualité du critique et ajuste le degré de confiance qu'il accorde à ses estimations lors de l'amélioration de la politique.
- Confirmer les changements dans la durée. Une politique est constituée de millions de nombres ajustables. Imaginez-les comme des boutons de réglage. Chaque mise à jour suggère un sens dans lequel tourner chacun d'eux. Certaines suggestions reflètent une véritable leçon, d'autres relèvent du hasard. En s'appuyant sur les travaux consacrés aux cautious optimizers (Liang et al., 2026), FLEX ne tourne un bouton que si la nouvelle suggestion va dans le même sens que celui dans lequel ce bouton a tourné récemment. Une leçon qui revient sans cesse est appliquée. Une suggestion isolée est ignorée.
Résultats sur des robots réels
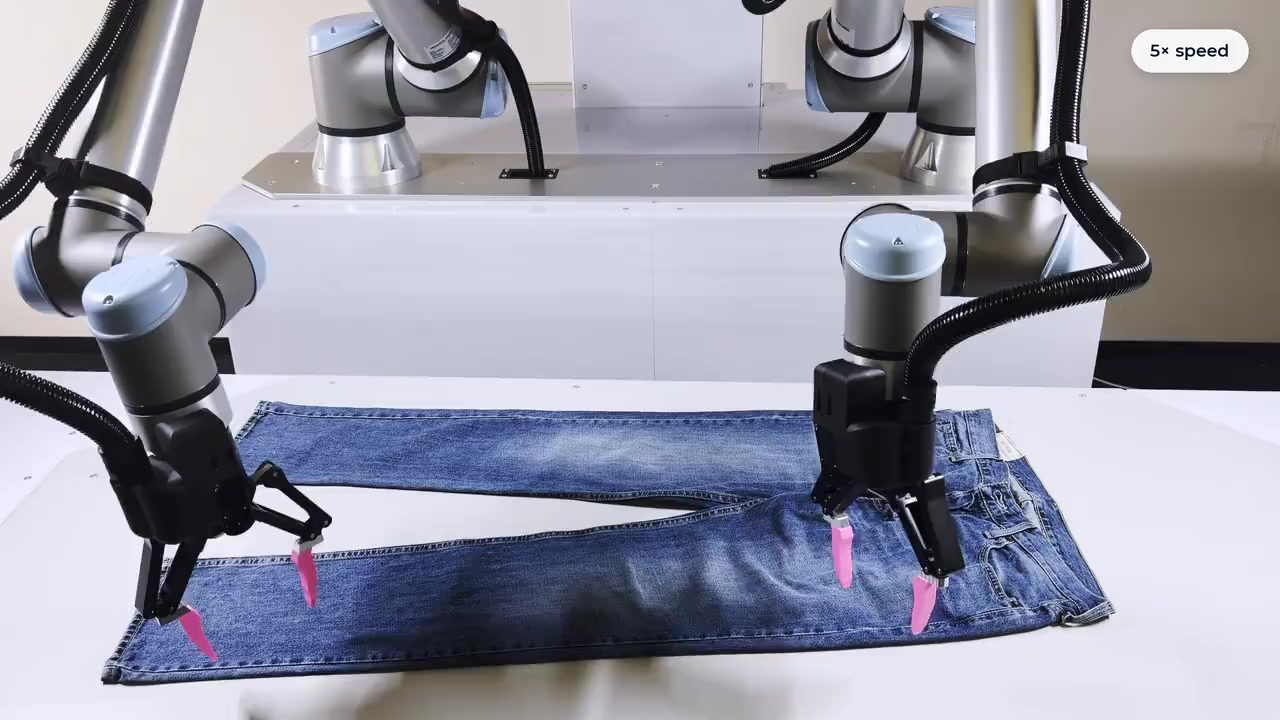
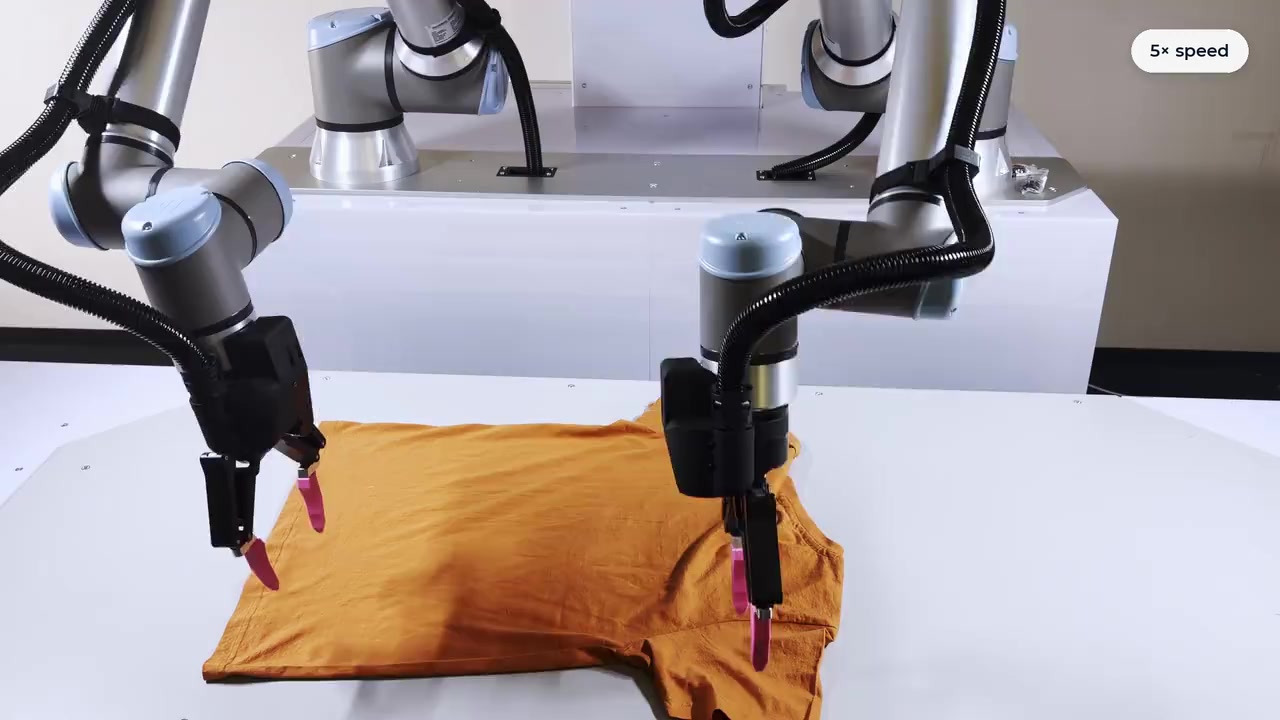
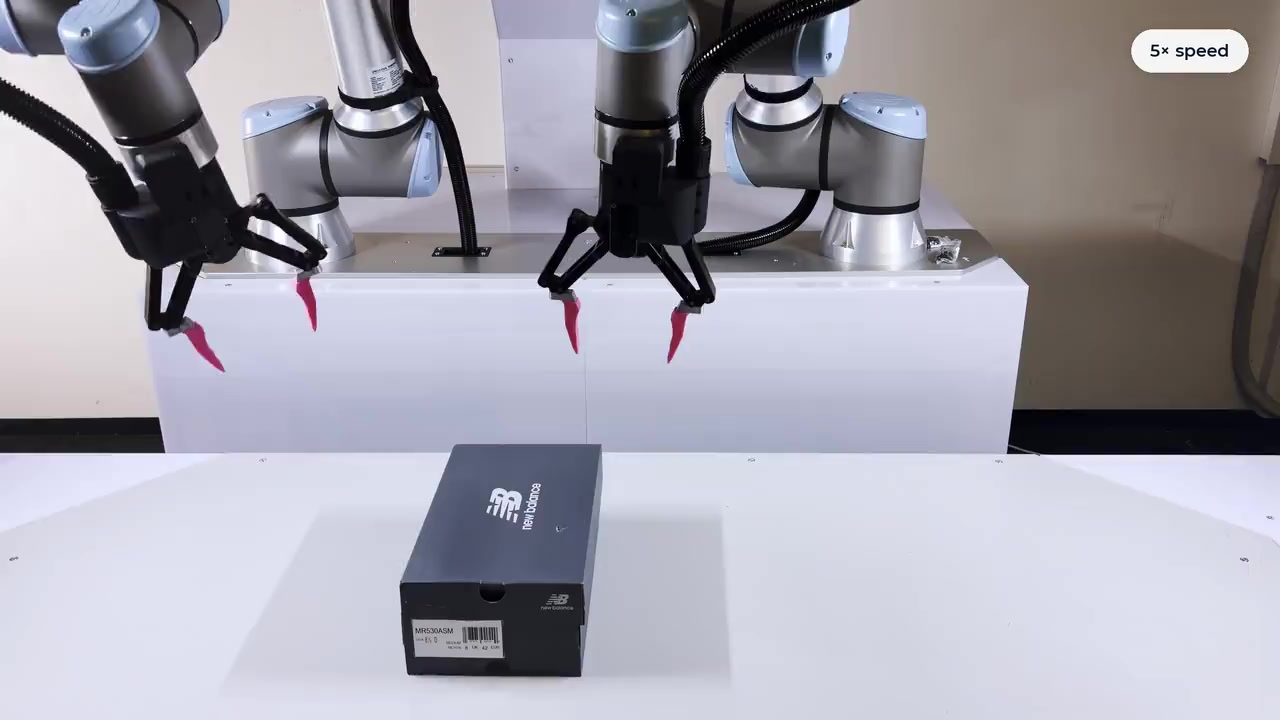
Chaque tâche partait de 100 démonstrations humaines collectées au préalable. Le robot s'est ensuite exercé pendant 10 cycles de 5 tentatives, sans que personne ne le corrige. Nous avons entraîné deux modèles : le backbone VLA de Cortex 2.0, pré-entraîné sur des données robotiques industrielles, et π0.5, un modèle accessible publiquement.
- Un meilleur pré-entraînement aide, mais jusqu'à une certaine limite. Tant qu'il repose sur l'imitation, Cortex 2.0 part devant π0.5 sur chaque tâche, ce qui montre que des VLAs pré-entraînés plus solides obtiennent de meilleures performances, mais plafonnent à 60-70% sur des tâches réelles.
- Un backbone plus solide tire davantage profit de la pratique. Les deux VLAs progressent, mais c'est l'application de FLEX à Cortex 2.0 qui donne la combinaison la plus performante. Avec la pratique, Cortex 2.0 a aussi appris à se rattraper après ses propres erreurs, par exemple en reprenant une saisie après un échec. π0.5 s'est surtout amélioré en commettant moins d'erreurs, sans découvrir de nouveaux comportements correctifs.
- Les deux sont devenus plus rapides. π0.5 a terminé 5 à 20% plus tôt après la pratique. Cortex 2.0 était déjà 17 à 48% plus rapide que π0.5, et la pratique l'a rendu encore plus rapide sur les trois tâches.
Conçu pour une flotte
Un robot qui s'exerce, c'est utile. De nombreux robots qui s'exercent pour une politique commune, c'est une manière d'apprendre qui passe à l'échelle, à partir d'une expérience accumulée sur toute la flotte et en croissance rapide. FLEX s'exécute sur un système d'apprentissage conçu pour le déploiement en flotte :
- Sur site, une copie locale de la politique tourne à côté des robots, de sorte que le contrôle n'attend jamais un serveur distant.
- L'expérience remonte. Chaque tentative est envoyée vers un buffer en ligne dans le cluster d'entraînement : images des caméras, état du robot, et réussite ou échec. Les démonstrations humaines collectées au préalable sont stockées dans un buffer hors ligne distinct.
- Les politiques redescendent. Un cluster GPU à grande échelle entraîne une politique commune sur l'expérience de tous les robots et envoie chaque nouvelle version à tous les sites.
Cela permet un apprentissage collectif, qui tire parti de l'expérience de toute la flotte pour accélérer les progrès. Si un robot découvre une nouvelle technique, celle-ci est diffusée à tous les robots avec la nouvelle version, ce qui leur permet de l'utiliser pour perfectionner encore leurs compétences.
Perspectives
FLEX montre qu'il est possible d'atteindre des taux de réussite élevés sur des tâches réelles à partir de quelques dizaines d'essais, sans aucune simulation ni correction humaine manuelle. Cela trace une voie claire vers des robots capables d'apprendre efficacement tout en créant de la valeur. Deux tendances indiquent les axes de passage à l'échelle. D'abord, FLEX bénéficie d'un pré-entraînement solide : il profitera donc des efforts visant à entraîner les modèles sur des volumes toujours plus importants de données de démonstration. Ensuite, FLEX étant prêt pour un déploiement à l'échelle de la flotte, il peut tirer parti de l'expérience accumulée par une flotte en croissance. Ensemble, ces deux tendances mènent à des robots qui améliorent rapidement leur efficacité, tout en étant fiables et générateurs de revenus.